画像生成モデル
NovelAI Diffusionには画像を生成する際に選択できる8つのモデルがあります。
モデルによって挙動は異なります。また、どのような画像を生成したいかによって、使うモデルを選んでいただく必要があります。
プロンプト欄の真上に表示されているのが、現在選択しているモデル名です。そこをクリックすると他のモデルに変更することができます。
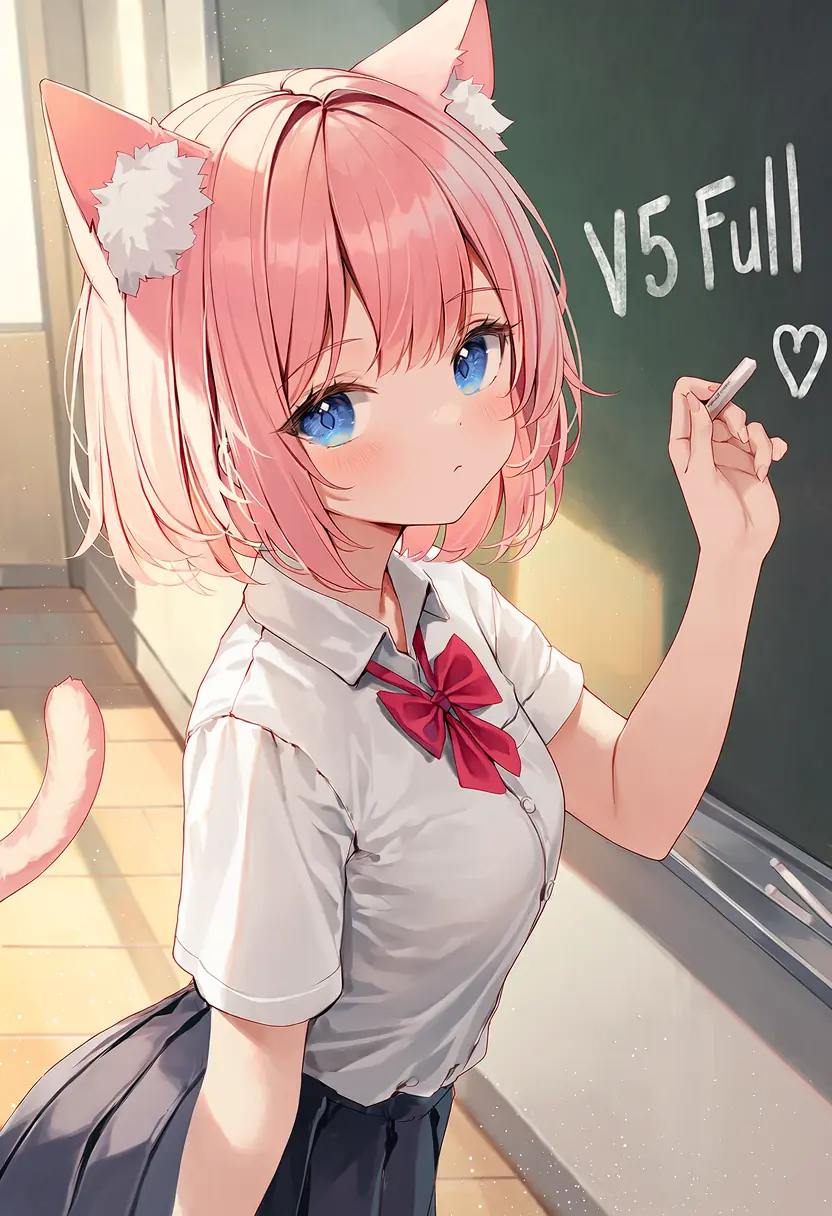
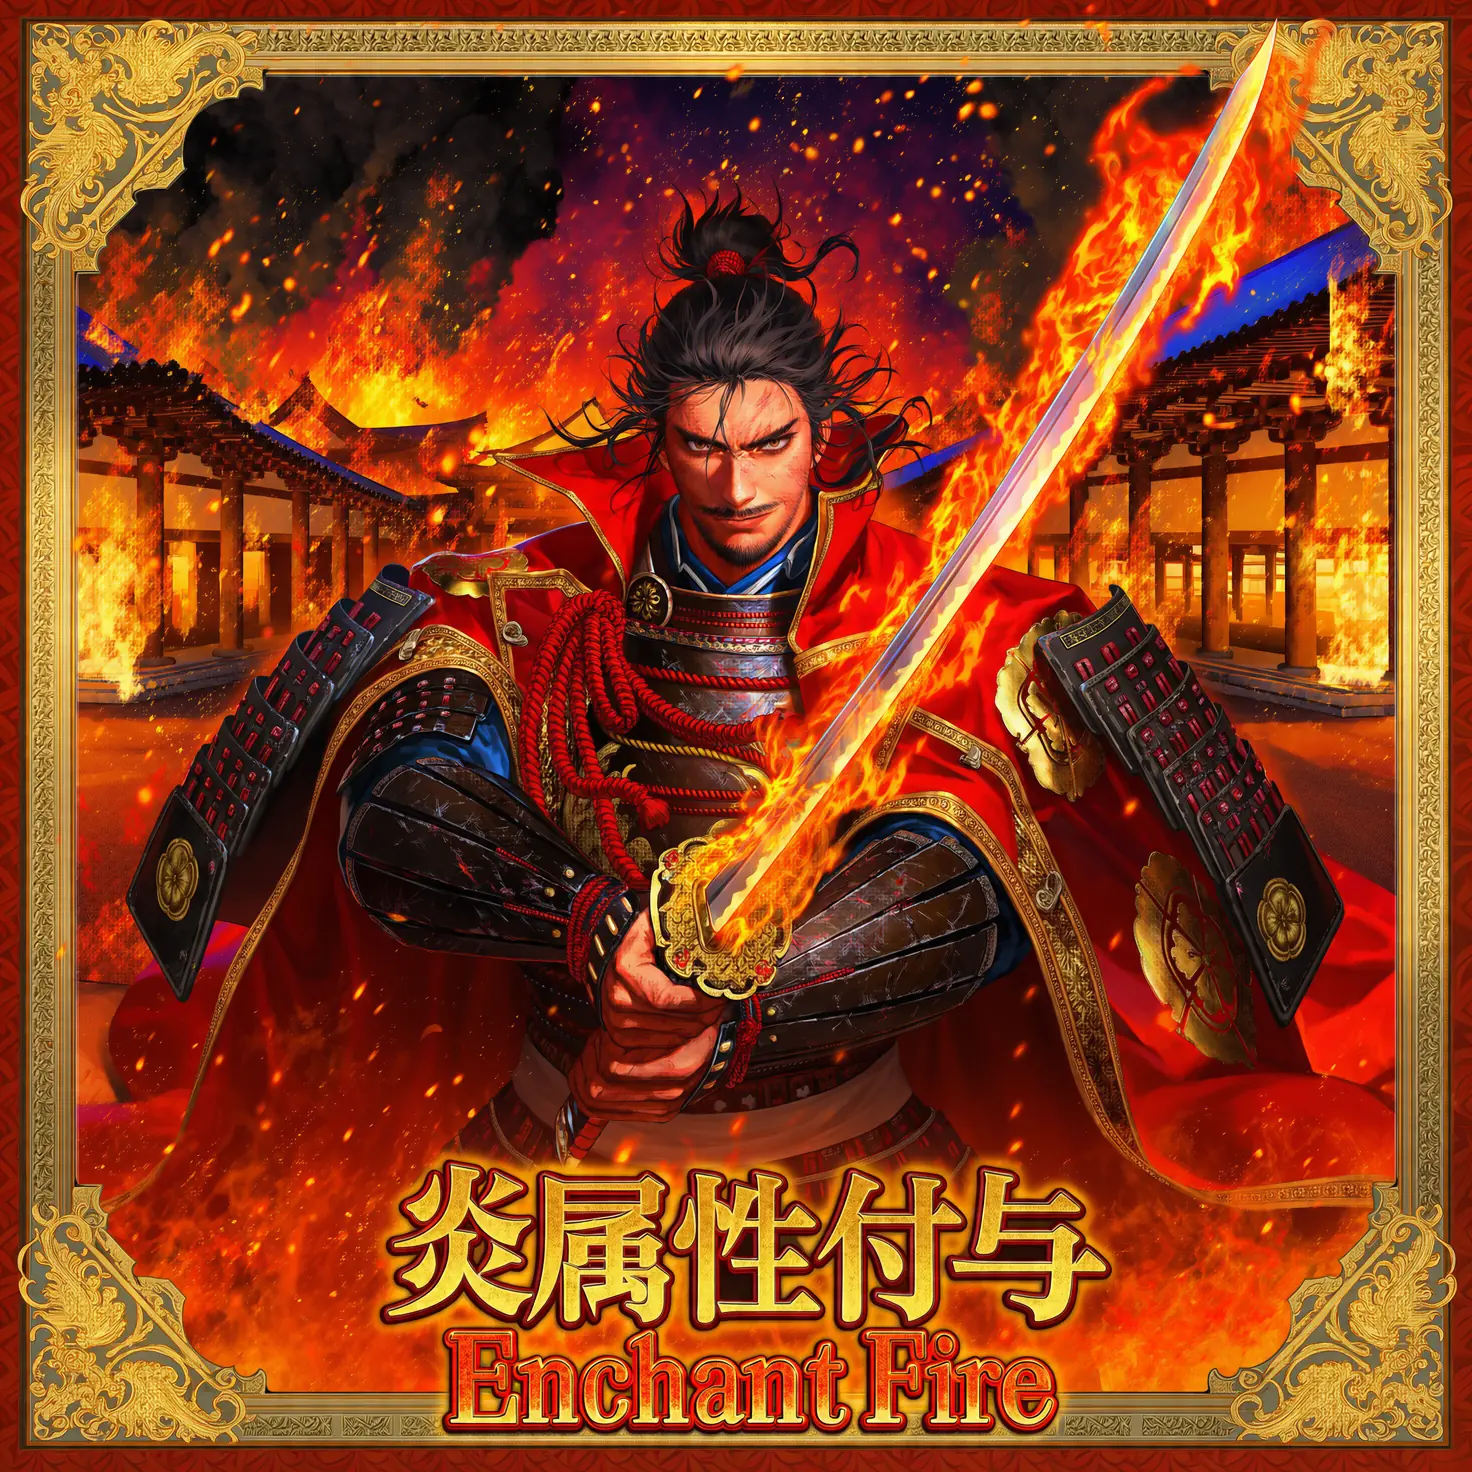
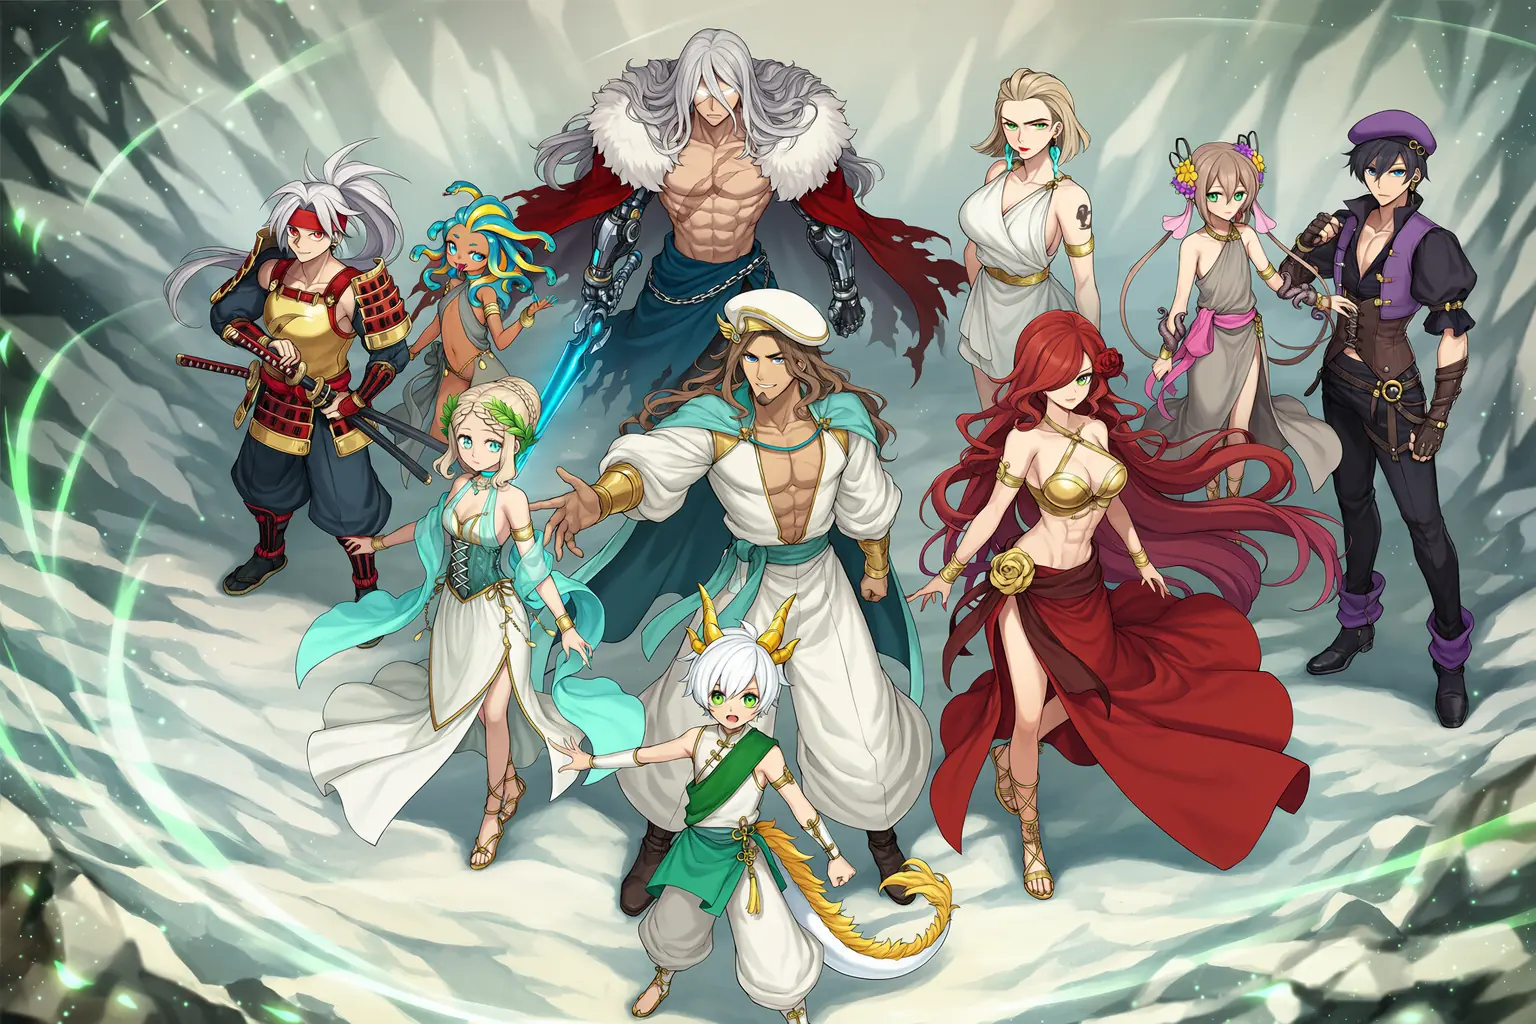
NovelAI Diffusion V5 Full
|
|
|
V5 FullはNovelAIの最新画像生成モデルです。すべての有料プランでご利用いただけます。
これはAnlatanが自社開発した完全オリジナルの画像生成モデルです。独自のアーキテクチャの開発とV4.5までの改良で得た知見を活かし、モデル規模を2倍に拡大しました。B200 GPUで合計268,000 GPU時間をかけて自社で訓練しています。NovelAI Diffusion V5は、個々の機能だけでなく、それらが組み合わさることで大きな進歩を実現しています。
V5では自然言語の理解力が向上し、日本語などの多言語プロンプト、アルファ透過を持つ画像の生成に対応しました。キャラクターの位置指定も改良され、複数キャラクターのプロンプトでは最大22人を指定できます。画像内の英語・日本語・中国語の文字描画も改善されています。これらの機能を組み合わせれば、コマ割りを含めた漫画を1枚の画像として生成することもできます。
これまでのFullモデルと同様に、NovelAI Diffusion V5 Fullモデルには、Curatedモデルと比べて、より幅広く多様なデータセットが含まれています。
コツ: 特定のものを生成しようとしてV5 Curatedモデルでは難しい場合は、V5 Fullモデルをお試しください!
V5 Fullのベースプロンプトには、最大約1,471有効トークンまで入力できます。文字描画では、空白と改行を含めて750文字以内の文章に対応しています。
ファーリーやケモノアートスタイルがお好きな方は、ケモノモードをオンにして、プロンプトの最初にfur dataset,タグを付けることで、これまでのFurryモデルと同様にプロンプトを作成できます。
同様に、background dataset,タグをプロンプトの最初に置くことで、風景、動物の肖像画、静物画など、人物が写っていない写真スタイルの画像を生成できます。
V5では、OpusユーザーのAnlasを消費しない画像生成に初めて利用制限が設けられました。従来のモデルはこの制限の対象外で、これまでどおり条件を満たせば無制限に生成できます。
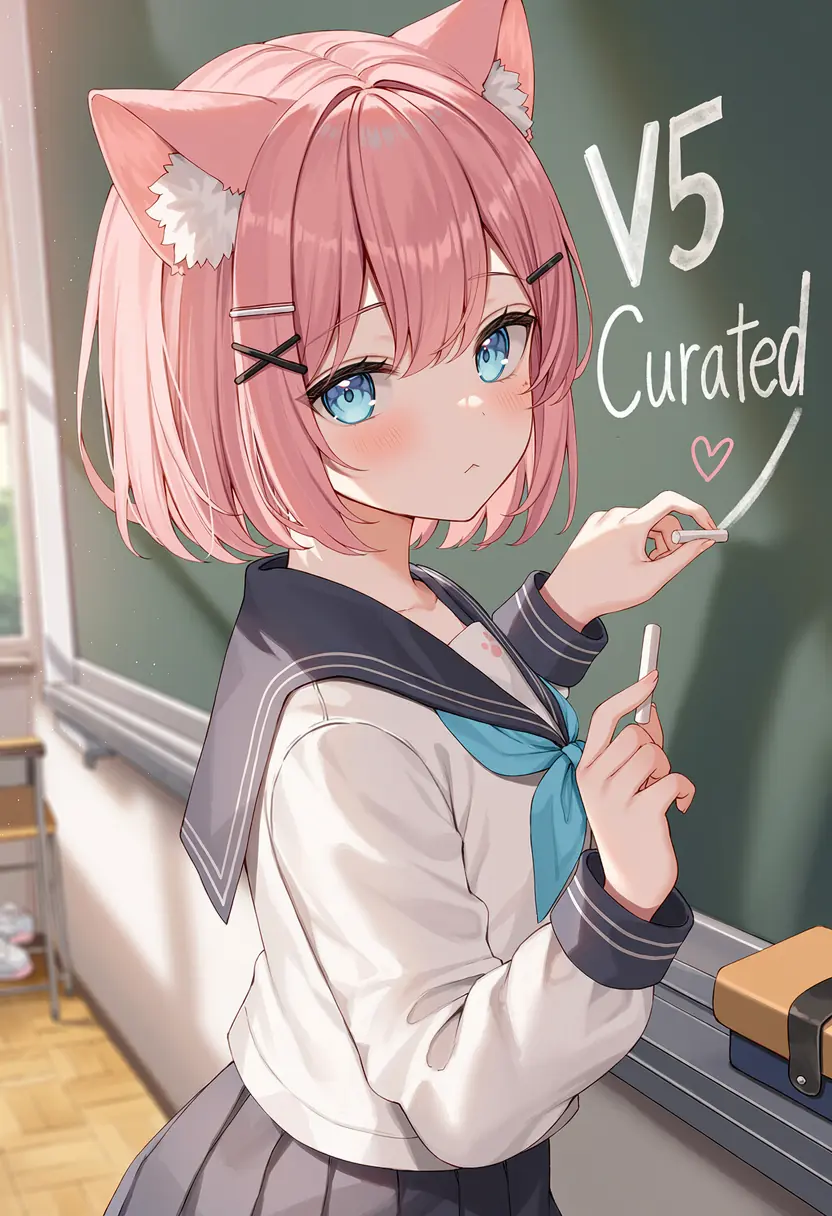
NovelAI Diffusion V5 Curated
|
|
|
V5 CuratedはNovelAIの最新画像生成モデルです。すべての有料プランでご利用いただけます。
これはAnlatanが自社開発した完全オリジナルの画像生成モデルです。独自のアーキテクチャの開発とV4.5までの改良で得た知見を活かし、モデル規模を2倍に拡大しました。B200 GPUで合計268,000 GPU時間をかけて自社で訓練しています。NovelAI Diffusion V5は、個々の機能だけでなく、それらが組み合わさることで大きな進歩を実現しています。
V5では自然言語の理解力が向上し、日本語などの多言語プロンプト、アルファ透過を持つ画像の生成に対応しました。キャラクターの位置指定も改良され、複数キャラクターのプロンプトでは最大22人を指定できます。画像内の英語・日本語・中国語の文字描画も改善されています。これらの機能を組み合わせれば、コマ割りを含めた漫画を1枚の画像として生成することもできます。
これまでのCuratedモデルと同様に、NovelAI Diffusion V5 Curatedモデルは、より質の高い厳選された画像の、やや小規模なデータセットで訓練されています。
コツ: Curatedモデルは、一般向けの題材を中心に楽しみたい方におすすめです。生成される内容はプロンプトなどによって変わるため、動画配信や公開の前には画像の内容をご確認ください。
V5 Curatedのベースプロンプトには、最大約703有効トークンまで入力できます。文字描画では、空白と改行を含めて374文字以内の文章に対応しています。
ファーリーやケモノアートスタイルがお好きな方は、ケモノモードをオンにして、プロンプトの最初にfur dataset,タグを付けることで、これまでのFurryモデルと同様にプロンプトを作成できます。
同様に、background dataset,タグをプロンプトの最初に置くことで、風景、動物の肖像画、静物画など、人物が写っていない写真スタイルの画像を生成できます。
V5では、OpusユーザーのAnlasを消費しない画像生成に初めて利用制限が設けられました。従来のモデルはこの制限の対象外で、これまでどおり条件を満たせば無制限に生成できます。
NovelAI Diffusion V4.5 Full
|
|
|
V4.5 FullはNovelAIの以前の画像生成モデルです。すべてのプランおよびご購入されたAnlasを消費してご利用いただけます。
これはAnlatanが自社開発した完全オリジナルの画像生成モデルで、V4.0での学習で得たすべての知見を実践に活かした結果です。V4.0と比較して、V4.5は全体的に扱いやすく意図どおりに制御でき、より高い生成精度とより美しい背景を実現しています。
これまでのFullモデルと同様に、NovelAI Diffusion V4.5 Fullモデルには、Curatedモデルと比べて、より幅広く多様なデータセットが含まれています。
コツ: 特定のものを生成しようとしてV4.5 Curatedモデルでは難しい場合は、V4.5 Fullモデルをお試しください!
V4.5では、V4.0のモデルアーキテクチャに数多くの変更と最適化を加え、生成全体の品質向上、視覚的アーティファクトの除去、様々な概念を学習する能力の向上を実現しました。これにより、V4.5は複数キャラクターでの画像プロンプト、英語の自然言語理解、画像内での英語の文字描画機能の更なる改善に対して、最高レベルのサポートを提供します。
V4.5はベースプロンプトとすべてのキャラクタープロンプトを合計して、最大約512トークンまで入力できます。
注意:V4.5はT5トークナイザーを使用するため、ほとんどのUnicode文字(カラフルな絵文字や日本語文字など)はサポートされていないことにご注意ください。
ファーリーやケモノアートスタイルがお好きな方は、ケモノモードをオンにして、プロンプトの最初にfur dataset,タグを付けることで、これまでのFurryモデルと同様にプロンプトを作成できます。
同様に、background dataset,タグをプロンプトの最初に置くことで、風景、動物の肖像画、静物画など、人物が写っていない写真スタイルの画像を生成できます。
最後に重要なことですが、V4.5は通常の条件を満たしている限り、Opusユーザーの無料生成も可能です。
NovelAI Diffusion V4.5 Curated
|
|
|
V4.5 CuratedはNovelAIの以前の画像生成モデルです。すべてのプランおよびご購入されたAnlasを消費してご利用いただけます。
これはAnlatanが自社開発した完全オリジナルの画像生成モデルで、V4.0での学習で得たすべての知見を実践に活かした結果です。V4.0と比較して、V4.5は全体的に扱いやすく意図どおりに制御できるモデルです。
これまでのCuratedモデルと同様に、NovelAI Diffusion V4.5 Curatedモデルは、より質の高い厳選された画像の、やや小規模なデータセットで訓練されています。
コツ: Curatedモデルは、一般向けの題材を中心に楽しみたい方におすすめです。生成される内容はプロンプトなどによって変わるため、動画配信や公開の前には画像の内容をご確認ください。
V4.5では、V4.0のモデルアーキテクチャに数多くの変更と最適化を加え、生成全体の品質向上、視覚的アーティファクトの除去、様々な概念を学習する能力の向上を実現しました。これにより、V4.5は複数キャラクターでの画像プロンプト、英語の自然言語理解、画像内での英語の文字描画機能の更なる改善に対して、最高レベルのサポートを提供します。
V4.5はベースプロンプトとすべてのキャラクタープロンプトを合計して、最大約512トークンまで入力できます。
注意:V4.5はT5トークナイザーを使用するため、ほとんどのUnicode文字(カラフルな絵文字や日本語文字など)はサポートされていないことにご注意ください。
ファーリーやケモノアートスタイルがお好きな方は、ケモノモードをオンにして、プロンプトの最初にfur dataset,タグを付けることで、これまでのFurryモデルと同様にプロンプトを作成できます。
同様に、background dataset,タグをプロンプトの最初に置くことで、風景、動物の肖像画、静物画など、人物が写っていない写真スタイルの画像を生成できます。
最後に重要なことですが、V4.5は通常の条件を満たしている限り、Opusユーザーの無料生成も可能です。
NovelAI Diffusion V4 Full
|
|
|
V4 FullはNovelAIの以前の画像生成モデルです。すべてのプランおよびご購入されたAnlasを消費してご利用いただけます。
これは、Stable Diffusionなどの公開ベースモデルに依存せず、NovelAIがゼロから訓練された完全オリジナル画像生成モデルの第一世代です。V4 Fullは、V4Curatedモデルと比べて、より幅広く多様なデータセットを含むだけでなく、V4 Curatedより1ヶ月新しいデータで更新されています。
コツ: 特定のものを生成しようとしてV4 Curatedモデルでは難しい場合は、V4 Fullモデルをお試しください!
V4 Fullは、複数キャラクターでの画像プロンプト、英語の自然言語理解、画像内での英語テキスト描画機能など、多くの新機能をツールボックスに追加します。これらすべてに加えて、詳細レベルの向上、創造性の改善、大幅に拡張・更新された知識ベース、そして大幅に拡張されたデータセットが付属しています。
V4モデルでは、ベースプロンプトとすべてのキャラクタープロンプトを合計して、最大約512トークンまで入力できるため、これまで以上にアイデアを表現するスペースが広がります。
注意:V4はT5トークナイザーを使用するため、ほとんどのUnicode文字(カラフルな絵文字や日本語文字など)はサポートされていないことにご注意ください。
ファーリーやケモノアートスタイルがお好きな方は、ケモノモードをオンにして、プロンプトの最初にfur dataset,タグを付けることで、これまでのFurryモデルと同様にプロンプトを作成できます。
最後に重要なことですが、V4は通常の条件を満たしている限り、Opusユーザーの無料生成も可能です。
NovelAI Diffusion V4 Curated
|
|
|
V4 CuratedはNovelAIのもう一つの以前の画像生成モデルです。すべてのプランおよびご購入されたAnlasを消費してご利用いただけます。
V4 Fullと同様に、これは、Stable Diffusionなどの公開ベースモデルに依存せず、NovelAIがゼロから訓練された完全オリジナル画像生成モデルの第一世代です。
V4 Fullと比較して、NovelAI Diffusion V4 Curatedモデルは、より質の高い厳選された画像の、やや小規模なデータセットで訓練されています。
コツ: Curatedモデルは、一般向けの題材を中心に楽しみたい方におすすめです。生成される内容はプロンプトなどによって変わるため、動画配信や公開の前には画像の内容をご確認ください。
このモデルも、複数キャラクターでの画像プロンプト、英語の自然言語理解、画像内での英語テキスト描画機能など、多くの新機能をツールボックスに追加します。これらすべてに加えて、詳細レベルの向上、創造性の改善、大幅に拡張・更新された知識ベース、そして大幅に拡張されたデータセットが付属しています。
V4モデルでは、ベースプロンプトとすべてのキャラクタープロンプトを合計して、最大約512トークンまで入力できるため、これまで以上にアイデアを表現するスペースが広がります。
注意:V4はT5トークナイザーを使用するため、ほとんどのUnicode文字(カラフルな絵文字や日本語文字など)はサポートされていないことにご注意ください。
ファーリーやケモノアートスタイルがお好きな方は、ケモノモードをオンにして、プロンプトの最初にfur dataset,タグを付けることで、これまでのFurryモデルと同様にプロンプトを作成できます。
最後に重要なことですが、V4は通常の条件を満たしている限り、Opusユーザーの無料生成も可能です。
NovelAI Diffusion Anime V3
|
|
|
V3モデルは当社の最先端のアニメ画像生成モデルです。すべてのサブスクリプションのティアでお使いいただけます。
このモデルはSDXLを基に当社独自の技術を取り入れています。当社の旧モデルと比較して、より優れたレベルの一貫性と知識を提供します。
さらにV3モデルには、プロンプト開始地点に近いところに置かれたタグほど重点が置かれるという特別な機能が備わりました。これにより、画像の生成結果を制御しやすくなっています。こちらに関しては、タグについてのページで詳しくご説明します。
V3モデルは、V2モデルが備える高いベース解像度(832x1216)の恩恵を受けたモデルです。さらに、Opusティアのユーザーは通常の条件を満たす限り無料で生成ができます。
NovelAI Diffusion Furry V3
|
|
|
FurryモデルがV3になって戻ってきました!
技術の進歩で最新のものとなったV3バージョンのFurryモデルは、品質と精度が大幅に向上しています。
NovelAI Diffusion Furry V3はAnime V3モデルと同様の高いベース解像度(832 x 1216)を持ち、同じサンプラー、タグの順序づけ、そしてバイブストランスファーへのアクセスを有しています。
FurryモデルではAnimeモデルと異なるタグが使われていることをお忘れなく。便利なタグ提案の機能を活用してくださいね!
ヒント:Furryモデルにトライして、このモデルの可能性にぜひ触れてみてね。ケモノアート以外のことにも優れているんだよ!
Retired
以下のモデルはモデル選択一覧には表示されませんが、参照目的で情報を残しています。
NovelAI Diffusion Anime V2
|
|
|
当社のAnime V2モデルは最初のモデルから一段階進化したモデルです。
このモデルにはV1と同じ技術が使われていますが、進化したトレーニング手法の恩恵を受けています。
またV2では、トレーニング解像度が上がりました。つまりSMEAサンプラーを使うことなくより高解像の画像を生成することができます。
NovelAI Diffusion Anime V2以降のモデルをお使いになる際は、デフォルトの縦型画像の解像度はV1の512 x 768から上がった832 x 1216になります。
現在、モデル選択リストからは利用できませんが、NovelAI Diffusion Anime V2 の重みはデュアルライセンス(CreativeML Open RAIL-M / CC BY-NC-SA 4.0)で公開しています。詳細はブログ記事をご覧ください:こちら
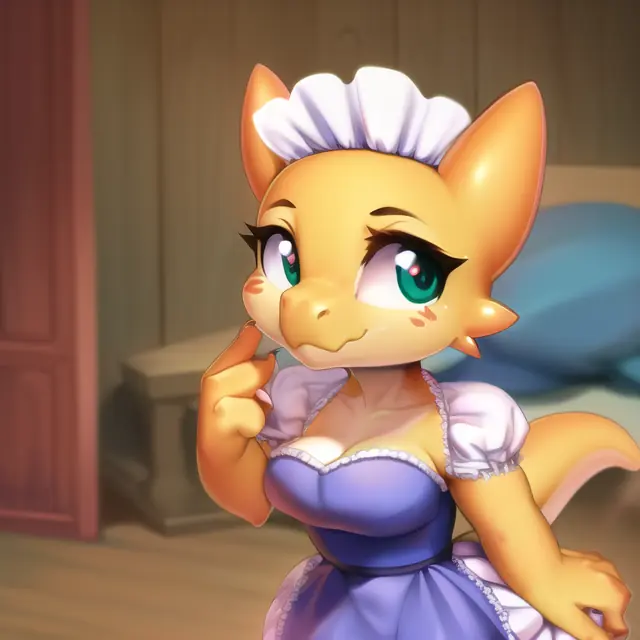
NovelAI Diffusion Furry (ベータ版V1.3)
|
|
|
NovelAI Diffusion Furry V1.3モデルは、ケモノ系や擬人化された動物をテーマとしたコンテンツを簡単に作れるモデルです。
こちらは旧バージョンのベータ版Furryモデルです。.
このモデルではAnimeモデルとは違ったタグを使いますのでご注意ください。
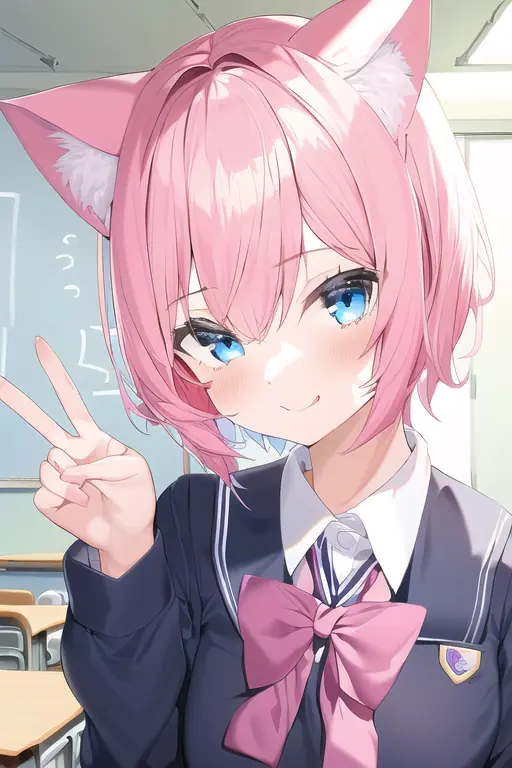
NovelAI Diffusion Anime (キュレート版)
|
|
|
NovelAI Diffusion Anime(キュレート版)モデルは、優れた基準品質を提供し、一般的な題材に対応しています。
よりクリーンで焦点を絞った画像から構成された、やや小さなトレーニングセットで訓練されたモデルです。
ヒント: この(キュレート版)モデルは、一般向けの題材を中心に楽しみたい方におすすめです。生成される内容はプロンプトなどによって変わるため、動画配信や公開の前には画像の内容をご確認ください。
NovelAI Diffusion Anime (フル)
|
|
|
NovelAI Diffusion Anime(フル)モデルはバラエティ豊かな生成を可能にする、拡張されたトレーニングセットを備えたモデルです。
このモデルはキュレート版と比べ、雑多なコンセプトの作品を扱いやすくなっています。
ヒント: もし何か特別に生成したいものがあって、(キュレート版)ではできそうにないと感じたら、この(フル)モデルを試してみてね!
注意:
NovelAI Diffusionモデルをご使用の際、Stable Diffusion 標準モデルと同じプロンプトとシード値を入力しても、同じ結果は出力されませんのでご注意ください。